여러 파일과 동적으로 생성한 데이터를 ZIP으로 묶되 완성된 압축 파일 전체를 메모리에 올리지 않고, 내부 서비스에서 API Gateway를 거쳐 Client까지 Stream으로 전달한 과정을 정리했다.
시작하며
운영 데이터를 외부에서 사용할 수 있도록 CSV, DB에서 만든 JSON, 데이터 노드의 이미지를 하나의 ZIP으로 내려주는 Export API를 구현했다. 다운로드는 인증을 담당하는 API Gateway를 거쳐야 했다.
구현하면서 수정한 곳은 Gateway의 응답 처리였다. 기존 관리자 API의 일반 JSON 프록시는 ZIP 바이너리를 문자열로 처리하는 문제가 있었다. 스트리밍 전용 프록시를 추가하고, Controller가 상태 코드와 헤더를 옮긴 뒤 응답 스트림을 직접 연결하도록 변경했다.
왜 이 경로를 분리해야 했는지 설명하려면 ZIP 생성 방식부터 볼 필요가 있다. 전체 ZIP을 메모리에 만드는 방식은 다음과 같다.
const zip = await createZipBuffer(entries);

response.setHeader('Content-Type', 'application/zip');
response.send(zip);
작은 파일에는 충분하지만 결과가 커지면 문제가 달라진다. 원본 데이터와 압축 결과가 동시에 메모리에 존재할 수 있고, 압축이 끝날 때까지 Client는 첫 Byte도 받지 못한다. 여러 사용자가 동시에 요청하면 프로세스 메모리도 빠르게 증가한다.
임시 ZIP 파일을 만든 뒤 내려주는 방법도 있지만 Disk 공간, 파일명 충돌과 비정상 종료 후 정리 문제를 추가로 관리해야 한다.
이번에는 입력 수집이 끝난 뒤 ZIP을 생성하면서 압축 결과를 HTTP 응답으로 흘려보내기로 했다. 하위 서비스 한 곳만 스트리밍해서는 부족하다. 중간의 API Gateway가 응답 전체를 다시 모으면 앞 단계의 장점이 사라진다.
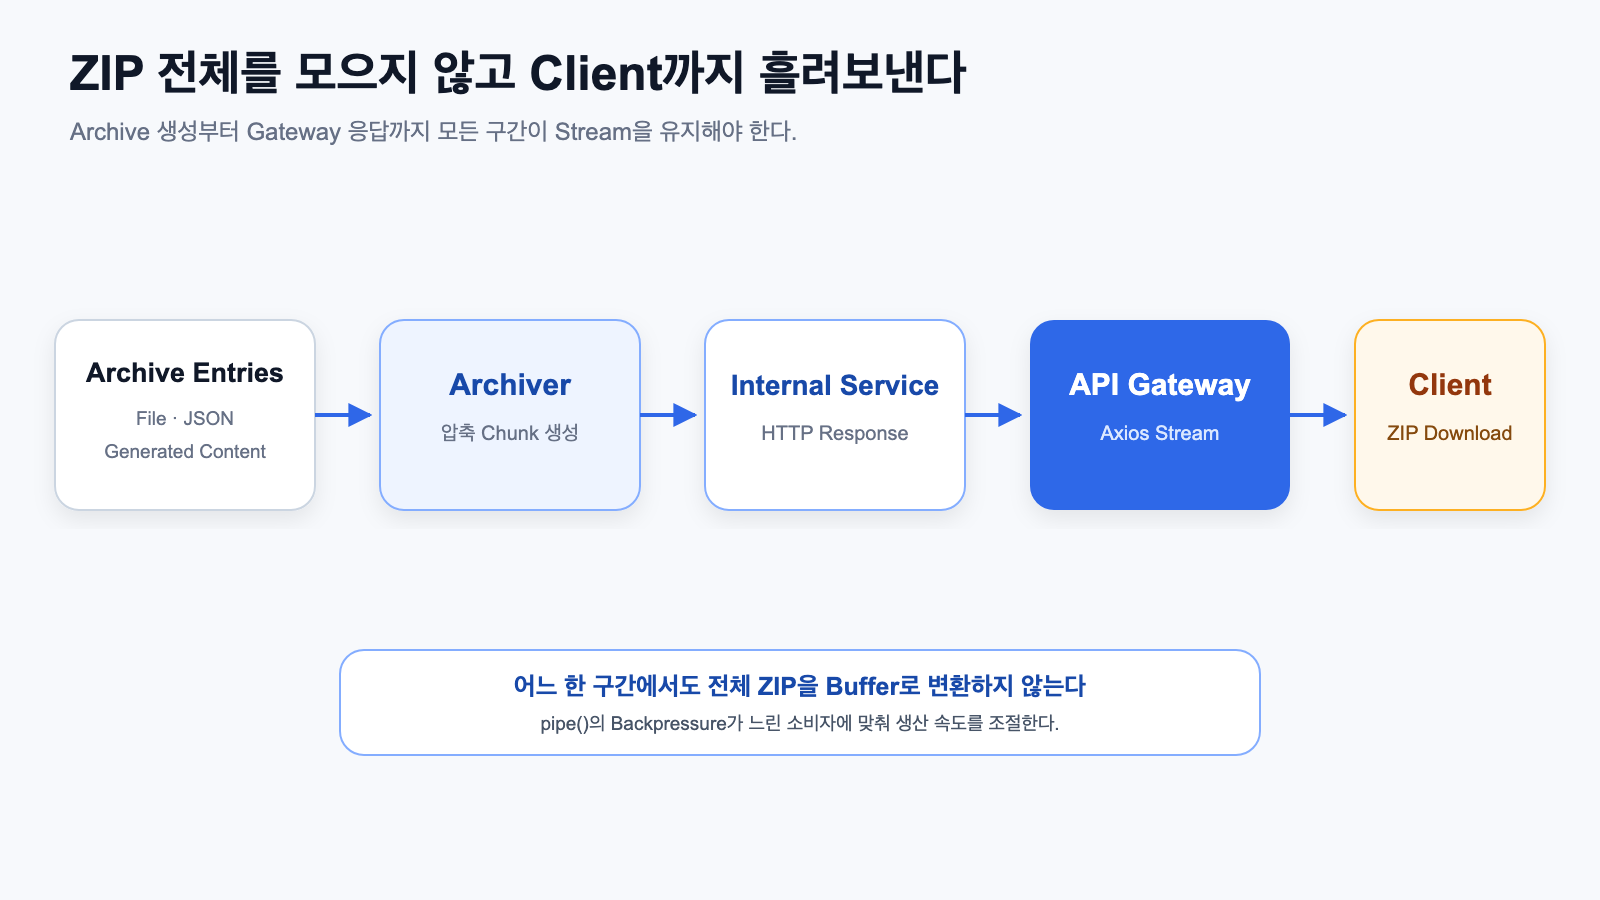
Archive 생성 → 내부 HTTP 응답 → API Gateway → Client모든 구간이 Stream을 유지해야 했다.
ZIP을 만들기 전에 입력 형식을 통일한다
ZIP에는 이미 존재하는 파일과 실행 중에 만든 데이터가 함께 들어간다.
- File System에 저장된 문서와 이미지
- DB 조회 결과로 만든 JSON
- 여러 Source에서 조합한 Metadata
압축 코드가 각 데이터의 생성 방법까지 알게 만들면 Source가 추가될 때마다 조건문이 늘어난다. 그래서 ZIP에 들어갈 대상을 공통 Entry로 정규화했다.
type ArchiveEntry = {
  zipPath: string;
  absolutePath?: string;
  content?: string | Buffer;
};
기존 파일은 absolutePath, 동적으로 만든 데이터는 content를 가진다. zipPath는 압축 파일 내부에서 보일 경로다.
for (const entry of entries) {
  if (entry.content !== undefined) {
    archive.append(entry.content, { name: entry.zipPath });
  } else if (entry.absolutePath) {
    archive.file(entry.absolutePath, { name: entry.zipPath });
  }
}
ZIP 생성 코드는 Source별 DB나 파일 규칙을 알지 않는다. 새로운 Source는 Entry 수집 단계에 추가하고, 압축 단계는 그대로 유지한다.
ZIP에는 같은 이름의 항목이 들어갈 수 있지만 압축 해제 도구에 따라 덮어쓰기나 중복 경고가 발생할 수 있다. 실제 구현에서는 이미 사용한 경로를 Set으로 관리하고 같은 이름이 나오면 순번을 붙여 충돌을 피한다.
reports/result.json
reports/result_1.json
reports/result_2.json
ZIP 내부 경로와 파일명도 외부 계약이다
처음에는 내려받은 이미지의 원본 파일명을 ZIP 안에서도 그대로 사용했다. 압축과 전송은 정상적으로 끝났지만, ZIP을 사용하는 쪽에서는 이미지가 어느 종류인지 구분하고 촬영 순서대로 정렬할 수 있어야 했다. 파일이 들어 있다는 사실만으로는 충분하지 않았고, 디렉터리와 파일명까지 소비자가 해석하는 데이터 계약이었다.
그래서 Export 대상 이미지의 종류를 정해진 폴더에 매핑하고, 원본 파일명 끝에 들어 있는 숫자를 추출해 ZIP 안의 이름을 다시 만들었다. 원본 수집기가 파일명 끝에 촬영 시각을 숫자로 기록하고 있었기 때문에 그 규칙을 이용했다.
원본
capture_device_42_20260903090000.jpg

ZIP 내부
left/20260903090000-left.jpg
확장자는 그대로 유지한다. 파일명 끝에 숫자가 없는 예외 입력은 이름 전체에서 확장자만 제거한 값을 대신 사용해, 이름을 만들지 못했다는 이유로 정상 파일까지 버리지 않게 했다.
function extractTrailingNumber(fileName: string): string {
  const extension = extname(fileName);
  const nameWithoutExtension = fileName.slice(
    0,
    fileName.length - extension.length,
  );
  const matched = /(\d+)$/.exec(nameWithoutExtension);

  return matched ? matched[1] : nameWithoutExtension;
}

const zipName = `${folder}/${extractTrailingNumber(fileName)}-${folder}${extname(fileName)}`;
여기서 폴더는 사용자가 보낸 문자열을 그대로 쓰지 않는다. 서버가 관리하는 허용 목록에서 데이터 출처와 폴더를 매핑한다.
const folderBySource = new Map([
  ['left-camera', 'left'],
  ['right-camera', 'right'],
  ['pan-tilt-camera', 'ptz'],
]);
예상하지 못한 출처를 임의의 폴더에 섞으면 ZIP을 읽는 쪽의 전제가 깨진다. 따라서 허용 목록에 없는 출처는 제외하고, 새 종류를 지원할 때 매핑과 테스트를 함께 추가하도록 했다.
이 작업에서 실패의 범위도 나눴다.
| 상황 | 처리 | 이유 |
|---|---|---|
| 이미지 목록 조회 실패 | Export 전체 실패 | 이미지가 없는 것과 목록을 가져오지 못한 것을 구분해야 함 |
| 목록에 있는 파일 한 개가 사라짐 | 해당 파일만 제외하고 계속 진행 | 파일 하나 때문에 나머지 결과까지 버리는 비용이 큼 |
| 허용 목록에 없는 출처 | 제외 | 소비자가 모르는 디렉터리 구조를 임의로 만들지 않음 |
| 파일명 끝 숫자가 없음 | 원본 이름을 기준으로 대체 이름 생성 | 정상 파일을 이름 규칙 하나 때문에 누락하지 않음 |
목록 조회 오류를 빈 목록으로 바꾸면 사용자는 “해당 기간에 이미지가 없었다”고 오해한다. 반대로 목록까지 정상적으로 받았는데 개별 파일 하나만 보관소에서 사라진 경우에는 나머지 파일로 ZIP을 만드는 편이 유용했다. 같은 Export 안에서도 전체 결과의 신뢰성을 깨뜨리는 실패와 일부 Entry에만 영향을 주는 실패를 구분해야 했다.
개별 이미지 다운로드 실패는 로그로 남기지만 현재 ZIP에는 누락 목록을 별도 파일로 넣지 않는다. 따라서 압축을 정상적으로 해제할 수 있다는 사실과 모든 원본이 포함됐다는 사실은 다르다. 빠진 파일까지 수신자가 확인해야 하는 용도라면 manifest.json에 요청·포함·누락 항목을 기록하는 개선이 필요하다.
테스트에서는 최종 ZIP 경로만 보는 대신 다음 계약을 각각 확인했다.
- 원본 파일명 끝 숫자가 새 파일명에 반영되는가
- 확장자가 유지되는가
- 출처별로 정해진 폴더에 들어가는가
- 지원하지 않는 출처가 제외되는가
- 파일 한 개의 다운로드 실패가 나머지 파일을 막지 않는가
- 목록 조회 실패가 빈 결과로 숨겨지지 않는가
이 과정을 거치면서 ZIP은 단순한 파일 묶음이 아니라는 점을 확인했다. HTTP 상태와 Header뿐 아니라 압축 내부의 디렉터리, 파일명, 누락 처리 방식도 Export API의 응답 형식이다.
Archiver를 HTTP Response에 직접 연결한다
내부 서비스는 archiver로 ZIP Stream을 만들고 Express Response에 직접 연결한다.
import { ZipArchive } from 'archiver';

const archive = new ZipArchive({
  zlib: { level: 9 },
});

archive.pipe(response);
Entry를 추가한 뒤 finalize()를 호출하면 Archive가 입력을 마무리하고 ZIP의 나머지 구조를 출력한다.
이 호출의 완료가 클라이언트의 다운로드 완료를 뜻하지는 않는다. 오류·종료 이벤트는 호출 전에 등록하고, 응답 스트림의 종료와 클라이언트 수신 결과를 따로 확인해야 한다. Archiver 공식 문서
for (const entry of entries) {
  if (entry.content !== undefined) {
    archive.append(entry.content, { name: entry.zipPath });
  } else if (entry.absolutePath) {
    archive.file(entry.absolutePath, { name: entry.zipPath });
  }
}

await archive.finalize();
처리 흐름은 다음과 같다.
Entry 읽기
    ↓
압축된 Chunk 생성
    ↓
HTTP Response에 기록
    ↓
다음 Entry 처리
완성된 ZIP 전체를 하나의 Buffer로 만든 뒤 전송하지 않는다. Node.js의 pipe()는 목적지의 처리 속도가 느려지면 읽는 속도도 조절하는 Backpressure를 제공한다.
완성된 ZIP은 저장하지 않지만 원격 이미지는 임시 저장한다
현재 구현에서 원격 이미지는 먼저 요청별 임시 디렉터리에 내려받는다. 수집이 끝나면 해당 파일을 Archiver에 넘긴다.
원격 이미지 → 다운로드 스트림 → 요청별 임시 파일
DB 조회 결과 → JSON 문자열
기존 CSV → 파일 경로
                     ↓ 입력 수집 완료
                  Archiver → 내부 HTTP 응답 → Gateway → 클라이언트
이미지는 pipeline(downloadStream, fileWriteStream)으로 디스크에 기록한다. 요청마다 mkdtemp로 작업 디렉터리를 만들고, 다운로드한 이미지 경로를 Entry에 넣는다. ZIP 처리 함수가 끝나거나 예외를 던지면 finally에서 작업 디렉터리를 정리한다.
따라서 이미지 수집 동안 디스크 공간을 사용하고 ZIP 전송 시작도 기다려야 한다. pipe()의 역압력은 연결된 스트림에 적용되며, 이미 끝난 DB 조회나 이미지 수집까지 조절하지 않는다. 프로세스가 강제 종료되면 남은 작업 디렉터리를 별도로 정리해야 한다.
| 방식 | 전송 시작 시점 | 주요 자원 비용 | 재다운로드 |
|---|---|---|---|
| ZIP 전체를 Buffer로 생성 | 압축 완료 후 | ZIP과 입력 데이터의 메모리 | 별도 보관이 없으면 재생성 |
| 현재 방식: 입력 수집 후 ZIP 스트리밍 | 입력 수집 후 압축과 함께 | 임시 이미지 디스크, JSON 문자열, 스트림 버퍼 | 처음부터 재생성 |
| 완성된 ZIP을 파일·Object Storage에 저장 | 생성 완료 후 | 결과 파일 저장 공간 | 보관 기간에는 결과 재사용 |
임시 파일 방식은 생성과 다운로드 단계를 분리할 수 있다는 장점이 있다.
데이터 수집
   ↓
임시 ZIP 생성
   ↓
생성 완료
   ↓
파일 다운로드
   ↓
임시 파일 삭제
하지만 요청마다 결과가 달라지고 같은 ZIP을 반복해서 사용할 필요가 없는 상황에서는 다음 운영 비용이 생긴다.
- 동시 생성되는 ZIP의 Disk 사용량
- 비정상 종료 후 남은 파일 정리
- 같은 파일명의 충돌 방지
- 다운로드 완료 여부와 삭제 시점 판단
- 여러 인스턴스 사이에서 Local Disk를 공유하지 못하는 문제
한 번 전달하는 현재 요구에는 완성된 ZIP을 보관하지 않는 방식이 맞았다. 다만 임시 이미지의 저장·정리 비용까지 사라진 것은 아니다.
반대로 생성 비용이 매우 크거나 같은 결과를 여러 번 내려받아야 한다면 임시 파일 또는 Object Storage가 더 적합하다. 비동기 Job으로 ZIP을 생성하고 완료 후 Pre-signed URL을 제공하면 다운로드 재시도와 CDN 활용도 쉬워진다.
Streaming이 항상 정답인 것이 아니라 결과의 재사용 여부와 생성 비용에 따른 선택이다.
Gateway의 일반 JSON Proxy를 그대로 쓸 수 없었다
내부 서비스가 ZIP을 Stream으로 보내더라도 Gateway가 이를 JSON이나 문자열로 해석하면 Binary가 손상될 수 있다. 일반 API Proxy와 파일 다운로드 Proxy를 분리한 이유다.
Gateway에서는 Axios 요청의 응답 형식을 stream으로 설정한다.
import { firstValueFrom } from 'rxjs';

const upstream = await firstValueFrom(httpService.request({
  method: request.method,
  url: upstreamUrl,
  headers: forwardedHeaders,
  responseType: 'stream',
  maxBodyLength: Infinity,
  maxContentLength: Infinity,
  validateStatus: () => true,
}));
NestJS의 HttpService.request()는 Observable을 반환하므로 firstValueFrom()으로 응답을 기다린다. 핵심은 다음 설정이다.
responseType: 'stream'maxBodyLength와 maxContentLength를 무제한으로 설정했다고 자동으로 Streaming이 되는 것은 아니다. 두 옵션은 Axios의 크기 제한을 해제한다. 응답을 Buffering하지 않고 Node.js Stream으로 받게 하는 것은 responseType이다.
실제 구현은 해당 관리자 Controller의 프록시를 이 메서드로 바꿨다. 이 경로에서는 ZIP과 JSON 오류 응답 모두 원본 상태·본문을 전달하며, 다른 일반 API 프록시는 기존 처리를 유지한다.
Gateway에서도 Stream을 그대로 연결한다
Gateway Controller는 Upstream의 Stream을 Client Response에 직접 연결한다.
const upstream = await proxyService.requestStream(request);

response.status(upstream.status);

const stream = upstream.data as NodeJS.ReadableStream;
stream.pipe(response);
전체 데이터 경로는 다음과 같다.
File / Generated Content
          ↓
       Archiver
          ↓ pipe
   Internal Service
          ↓ HTTP Stream
      API Gateway
          ↓ pipe
        Client
Gateway가 await streamToBuffer(upstream) 같은 처리를 한 뒤 response.send()하면 최종 ZIP이 다시 Gateway 메모리에 올라간다. Stream을 Stream으로 연결해야 End-to-end Streaming이 유지된다.
공통 응답 Interceptor의 JSON Wrapper를 적용하지 않는다
Gateway의 일반 API는 공통 Interceptor에서 성공 응답을 일정한 JSON 형식으로 감싼다.
{
  "success": true,
  "statusCode": 200,
  "data": {}
}
JSON API에는 유용하지만 ZIP Stream에 같은 Wrapper를 적용할 수는 없다. Binary Stream을 data에 넣기 위해 읽기 시작하면 전체 응답을 다시 모아야 하고, 응답의 Content-Type도 JSON과 ZIP 중 하나로 결정할 수 없게 된다.
일반 API
└── 반환값 → 공통 Interceptor → JSON 직렬화

ZIP API
└── Upstream Stream → Express Response에 직접 pipe
현재 ZIP Controller는 NestJS가 반환값을 자동으로 직렬화하게 두지 않고 @Res()로 Express Response를 직접 제어한다.
async download(
  @Req() request: Request,
  @Res() response: Response,
) {
  const upstream = await proxyService.requestStream(request);
  upstream.data.pipe(response);
}
전역 Interceptor 자체가 실행되지 않는다는 뜻은 아니다. Interceptor는 요청 흐름에 참여하지만, Controller가 이미 상태와 Header를 설정하고 Stream을 Response에 직접 기록하므로 NestJS의 표준 JSON 응답 직렬화 경로를 사용하지 않는다.
이 방식은 동작하지만 코드만 읽었을 때 의도가 분명하지 않다. Binary나 Stream 응답이 늘어난다면 @RawResponse() 같은 Metadata를 만들고 공통 Interceptor가 이를 명시적으로 통과시키는 편이 안전하다.
const isRawResponse = reflector.getAllAndOverride<boolean>(
  RAW_RESPONSE,
  [context.getHandler(), context.getClass()],
);

if (isRawResponse) {
  return next.handle();
}
이렇게 하면 직접 @Res()를 사용했다는 구현 세부사항보다 “이 Endpoint는 공통 JSON Wrapper를 적용하지 않는다”는 응답 정책이 코드에 드러난다.
Status와 Header도 다운로드 계약의 일부다
본문 Byte만 전달해서는 다운로드 Proxy가 완성되지 않는다. Gateway는 Upstream의 상태 코드와 파일 관련 Header를 Client에 전달한다.
response.status(upstream.status);

for (const name of [
  'content-type',
  'content-disposition',
  'content-length',
  'cache-control',
]) {
  const value = upstream.headers[name];
  if (value) response.setHeader(name, value);
}
각 Header에는 다음 역할이 있다.
Content-Type: ZIP Binary임을 알린다.Content-Disposition: 다운로드 파일명을 전달한다.Content-Length: 크기를 미리 알 수 있을 때 진행률 계산에 사용한다.Cache-Control: 중간 Cache 정책을 결정한다.
현재 복사하는 헤더는 위 네 개다. 하위 서비스가 Retry-After를 보내더라도 지금의 허용 목록에는 없으므로 전달되지 않는다. 재시도 간격을 안내하려면 별도로 추가해야 한다.
동적으로 생성하는 ZIP은 최종 크기를 미리 알기 어려워 Content-Length가 없을 수 있다. 길이를 계산하려고 전체를 모으면 스트리밍의 장점이 사라진다. HTTP/1.1에서는 보통 chunked 전송을 사용하며, HTTP/2에서는 해당 프로토콜의 프레임으로 전달한다.
오류 상태도 Stream으로 전달한다
Axios는 기본적으로 4xx와 5xx 응답을 예외로 바꾼다. Streaming Proxy에서는 다음 설정으로 모든 HTTP 상태를 Response로 받는다.
validateStatus: () => trueGateway가 Upstream의 상태를 그대로 적용하면 오류 종류를 보존할 수 있다.
response.status(upstream.status);예를 들어 다음 상태가 모두 하나의 502로 바뀌지 않는다.
- 인증 실패
- 권한 부족
- 내보낼 데이터 없음
- 요청 횟수 제한
- 내부 서비스 오류
responseType: 'stream'에서는 오류 본문도 Stream이다. 따라서 성공 ZIP뿐 아니라 오류 Response의 상태, Header와 Body도 함께 전달되는지 통합 테스트가 필요하다.
전송 중 오류는 상태 코드로 바꿀 수 없다
Streaming 응답은 오류가 발생한 시점에 따라 처리 방법이 달라진다.
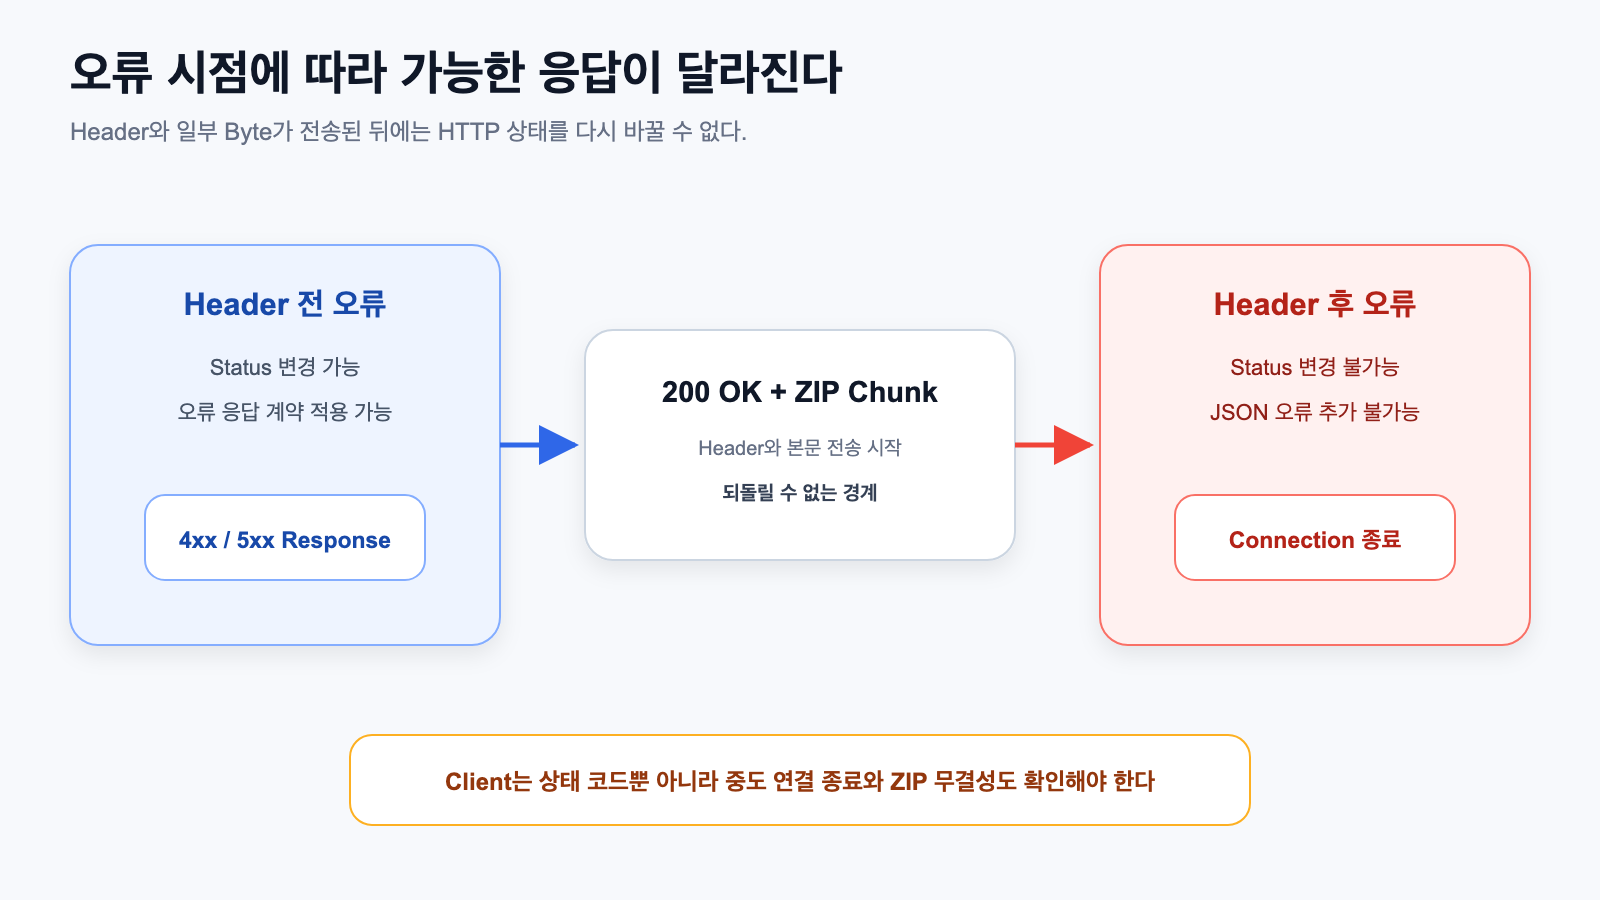
입력 수집 중 예외가 발생하고 아직 응답을 시작하지 않았다면 일반 오류 응답을 보낼 수 있다. 반면 아래 Archive 오류 핸들러는 연결을 종료하는 코드다.
archive.on('error', (error) => {
  if (!response.headersSent) {
    response.status(500);
  }

  response.destroy(error);
});
하지만 일부 ZIP Byte와 200 OK가 이미 전송됐다면 JSON 오류 응답으로 바꿀 수 없다. 새로운 상태 코드와 Body를 보내면 하나의 HTTP 응답에 서로 다른 형식이 섞인다.
위 코드의 status(500)은 상태값 설정에 불과하다. 이어서 destroy()하면 500 응답이 전송되기 전에 연결이 닫힐 수도 있다. 클라이언트는 500 응답 대신 연결 종료만 감지할 수 있다. 헤더 전송 전 오류를 JSON으로 안내하려면 ZIP용 헤더를 정리하고 오류 응답을 명시적으로 끝내는 별도 처리가 필요하다. Node.js HTTP 문서
Gateway에서도 Upstream Stream이 중간에 실패하면 Client 연결을 끊는다.
stream.on('error', () => {
  response.destroy();
});
손상된 ZIP을 정상적으로 끝난 파일처럼 보이게 두지 않기 위한 선택이다. Client는 HTTP 상태뿐 아니라 다운로드 중 연결 종료와 ZIP 무결성도 실패로 처리해야 한다.
메모리를 전혀 사용하지 않는 것은 아니다
Streaming이라는 표현 때문에 모든 데이터가 한 Byte씩만 메모리를 지나간다고 오해하기 쉽다. 현재 구현은 ZIP 전체와 기존 파일 본문 전체를 Buffer로 만들지 않지만 Entry 목록을 먼저 수집한다.
동적으로 만든 JSON도 문자열로 생성한 뒤 archive.append()에 전달한다. JSON 하나가 매우 크다면 그 문자열은 메모리에 존재한다.
즉, 스트리밍으로 줄인 것은 최종 ZIP과 기존 파일 본문을 한꺼번에 보관하는 메모리다. Entry 목록과 동적으로 생성한 JSON에 필요한 메모리는 여전히 남는다.
Entry Metadata가 많거나 생성 데이터가 커지면 다음 단계가 필요하다.
- DB 결과를 Cursor나 Pagination으로 읽기
- JSON을
ReadableStream으로 생성하기 - Entry 수집과 압축 시작을 Pipeline으로 연결하기
- 동시 Export 개수 제한하기
메모리 사용량을 판단할 때는 ZIP 전송 버퍼뿐 아니라 Entry 수와 가장 큰 JSON 문자열의 크기도 함께 봐야 한다.
현재 구조에서 남은 과제
ZIP 요청은 여러 DB Query, File System 읽기, 압축 CPU와 긴 HTTP 연결을 사용한다. 일반 JSON API보다 비용이 크므로 동시 실행 수나 호출 횟수를 별도로 제한할 필요가 있다. 여러 인스턴스에서 동일한 제한을 적용해야 한다면 프로세스 메모리가 아닌 공유 저장소 기반 Rate Limiter가 필요하다.
높은 압축 Level도 항상 유리하지 않다. 이미지처럼 이미 압축된 파일이 많으면 CPU 사용량에 비해 결과 크기 감소가 작을 수 있으므로 실제 데이터로 압축 시간과 크기를 측정해야 한다.
Client 연결 종료 시 작업을 취소해야 한다
Archive와 Upstream의 오류 처리는 있지만, Client가 먼저 연결을 끊었을 때 진행 중인 압축과 파일 읽기까지 취소하는 처리는 더 보완해야 한다.
response.on('close', () => {
  archive.abort();
});
취소 처리를 추가할 때는 response.writableFinished 등으로 정상 완료와 중도 종료를 구분하고, Gateway의 상류 요청부터 파일 읽기와 수집 작업까지 취소를 전달해야 한다. archive.abort()만으로 모든 입력 작업이 즉시 취소되는 것은 아니다. Archiver abort 문서
임시 이미지 정리도 함께 봐야 한다. 현재 finally가 실행되는 시점과 모든 입력 파일의 읽기가 끝난 시점이 오류 경로에서도 맞는지 확인해야 하며, 연결만 끊고 압축이 계속되는 상태에서 파일부터 삭제하면 정리 과정이 또 다른 오류를 만들 수 있다.
중간 실패 후 이어받을 수 없다
동적으로 생성하는 ZIP에는 Range Request나 부분 재개가 없다. 전송 중 실패하면 처음부터 다시 생성하고 다운로드해야 한다.
파일 크기와 생성 시간이 더 커진다면 비동기 Export Job으로 전환하고 완성된 결과를 Object Storage에 보관하는 편이 적합하다.
Streaming이 시작되면 공통 오류 형식을 사용할 수 없다
Header가 전송된 뒤에는 애플리케이션의 공통 JSON 오류 계약으로 전환할 수 없다. Streaming Endpoint의 실패 계약을 별도로 문서화하고 Client가 연결 종료를 오류로 처리하게 해야 한다.
관측 지표가 필요하다
다음 정보를 측정하면 병목과 실패를 찾기 쉽다.
- 첫 Byte가 전송되기까지 걸린 시간
- 전체 다운로드 시간과 전송 Byte
- 압축 CPU 시간
- 동시 Export 수
- Client 중도 종료 횟수
- 내부 서비스와 Gateway 구간별 오류
다운로드가 정상인지 확인하는 방법
파일이 저장됐다는 사실만으로 정상 여부를 판단하면 안 된다. Gateway가 JSON 오류를 그대로 전달한 경우에도 저장된 파일의 확장자는 .zip일 수 있다. 먼저 상태와 헤더를 확인하고, ZIP 구조와 내부 파일을 각각 확인한다.
curl --silent --show-error \
  --dump-header export.headers \
  --output export.zip \
  'https://api.example.com/admin/export?site_id=42'

unzip -t export.zip
unzip -l export.zip
요청 URL과 인증은 실제 환경에 맞게 지정한다. export.headers에서 HTTP 상태와 Content-Type, Content-Disposition을 먼저 본다. unzip -t는 압축 데이터의 CRC 등을 검사하지만 업무상 필요한 파일의 누락까지 알려주지는 않는다. unzip -l 결과를 기대한 디렉터리·파일 목록과 대조해야 한다.
단위 테스트에서는 이미지 폴더 분류, 다운로드의 스트림 설정, 개별 이미지 실패와 목록 조회 실패의 처리 차이를 검증한다. 실제 다운로드에서는 여기에 상태 코드, 헤더, ZIP 내부 파일까지 함께 확인해야 한다.
| 확인할 상황 | 확인할 결과 |
|---|---|
| 내부 서비스와 Gateway를 통한 다운로드 | 각각 압축 검사를 통과하고 내부 파일 내용이 일치하는지 |
| 하위 서비스가 JSON 오류를 반환 | 원래 상태·Content-Type·오류 본문이 전달되는지 |
| 이미지 한 개 다운로드 실패 | 나머지 이미지가 포함되고 실패 로그가 남는지 |
| 이미지 목록 조회 실패 | 빈 이미지 폴더를 가진 성공 ZIP으로 숨겨지지 않는지 |
| ZIP 전송 도중 상류 연결 종료 | 다운로드 실패나 ZIP 무결성 오류로 드러나는지 |
| 느린 클라이언트·동시 다운로드 | 전체 ZIP 크기만큼 메모리가 계속 쌓이지 않는지 |
| 클라이언트가 중간에 취소 | 상류 요청·압축·임시 파일 정리가 어디까지 끝나는지 |
연속으로 생성한 ZIP은 항목 시각 같은 메타데이터 때문에 바이트가 달라질 수 있으므로 ZIP 파일 자체의 해시만으로 비교하지 않는다. 압축을 푼 파일의 내용과 경로를 비교한다.
- JSON 프록시를 거치지 않고 Gateway까지 응답 스트림이 유지된다.
- 다운로드 상태·파일명·본문 형식이 올바르게 전달된다.
- ZIP 무결성과 업무상 필요한 파일 구성을 각각 확인했다.
- 이미지 준비 시간과 ZIP 전송 시간을 구분해 측정했다.
- JSON 메모리와 임시 이미지 디스크 사용량을 함께 확인했다.
- 개별 파일 누락과 전체 실패를 구분했다.
- 전송 중 오류와 사용자 취소를 성공 완료로 기록하지 않는다.
이번 구현으로 최종 ZIP 전체를 모으는 처리를 없앴다. 실제 메모리 사용량과 다운로드 시간은 입력 크기, 동시 요청 수, 압축 비용에 따라 달라지므로 부하 테스트로 확인해야 한다. 특히 앞단에 Nginx나 다른 프록시가 있거나 브라우저 코드가 response.blob()으로 전체를 모은다면 그 구간의 버퍼링도 확인해야 한다.
마치며
대용량 ZIP 다운로드는 Content-Type을 설정하고 파일을 보내는 것만으로 끝나지 않았다. 하위 서비스가 압축 결과를 Stream으로 만들고, HTTP Client가 Binary를 Stream으로 받으며, Gateway가 다시 Client Response에 연결해야 전체 경로에서 Buffering을 피할 수 있었다.
이번 구현의 핵심은 다음과 같다.
- 파일과 생성 데이터를 공통 Archive Entry로 정규화한다.
- ZIP 내부 경로와 파일명도 소비자가 의존하는 계약으로 관리한다.
- 전체 실패와 개별 Entry 실패의 처리 범위를 구분한다.
- Archiver를 내부 서비스 Response에 직접 연결한다.
- 원격 이미지는 임시 저장하되 최종 ZIP 전체는 Buffer나 파일로 만들지 않는다.
- Gateway의 Axios 응답을
stream으로 받는다. - Gateway도 Upstream Stream을 Client Response로 바로 연결한다.
- ZIP Endpoint는 공통 JSON 응답 직렬화 경로를 사용하지 않는다.
- 상태 코드와 다운로드 Header를 함께 전달한다.
- Header 전송 후 오류는 상태 변경 대신 연결 종료로 처리한다.
- Streaming이 제거하지 못한 메모리 사용과 운영 비용도 구분한다.
Streaming은 한 줄의 pipe()가 아니라 요청 경로 전체가 지켜야 하는 계약이다. 어느 한 구간이라도 응답 전체를 모으기 시작하면 대용량 파일에서 얻고자 했던 메모리와 응답 시간의 장점이 사라진다.
'Backend > Architecture' 카테고리의 다른 글
| [Architecture] 엣지 서버의 로컬 ID와 전역 ID 충돌을 피하는 방법 (0) | 2026.09.20 |
|---|---|
| [Server] 사용자 JWT와 장비 Token의 인증 경계를 분리하기 (0) | 2026.09.19 |
| [Refactoring] 레거시 API를 이식할 때 계약과 버그를 구분하는 방법 (0) | 2026.09.13 |
| [Design Pattern] 서로 다른 데이터 스키마를 하나의 API로 다루기 (0) | 2026.08.18 |
| [Server] 보상 작업으로 다단계 생성 흐름의 실패 범위 줄이기 (0) | 2026.08.15 |
| [Server] 여러 API 서비스의 인증을 Gateway에 모은 이유 (0) | 2026.08.08 |


