레거시 API를 새로운 서버로 옮기면서 외부 계약은 보존하고, 내부 구현은 재구성하며, 명확한 버그는 회귀 테스트와 함께 수정한 기준을 정리했다.
시작하며
기존 앱이 사용하는 API를 새 DB에 연결하는 호환 서버를 만들고, 레거시의 설정 관리 기능을 새 API로 옮겼다. 두 작업 모두 기존 코드를 읽는 것에서 출발했지만, 바꿀 수 있는 범위는 달랐다.
기존 앱을 그대로 유지하는 경로는 요청과 응답을 보존해야 했다. 호출자도 함께 바꾸는 설정 관리 API는 엔드포인트를 역할별로 나눌 수 있었다. 이 차이를 먼저 정하지 않으면 같은 변경을 두고도 한쪽에서는 개선, 다른 쪽에서는 장애가 된다.
| 이식 범위 | 유지해야 하는 것 | 바꿀 수 있는 것 |
|---|---|---|
| 기존 앱을 유지하는 호환 서버 | 앱이 보내는 요청, 읽는 필드와 타입, 기대하는 결과 | 새 스키마에 맞춘 SQL과 내부 모듈 |
| 호출자도 함께 전환하는 신규 API | 합의한 업무 동작과 외부 시스템 연동 계약 | 엔드포인트 분리, DTO와 응답 필드 정리 |
오래된 코드에는 서로 다른 성격의 동작이 섞여 있었다.
- 클라이언트와 외부 시스템이 의존하는 계약
- 외부에서는 알 필요가 없는 내부 구현
- 오랫동안 발견되지 않았을 뿐인 버그
이 셋을 구분하지 않고 복사하면 기존 호출자를 깨뜨리거나, 반대로 이미 알고 있는 버그까지 새로운 코드로 옮기게 된다.
이번 이식에서는 레거시 코드를 정답으로 두지 않았다. 먼저 기존 API의 요청과 응답, 외부 연동, 데이터 관계를 조사하고 각 동작을 다음과 같이 분류했다.
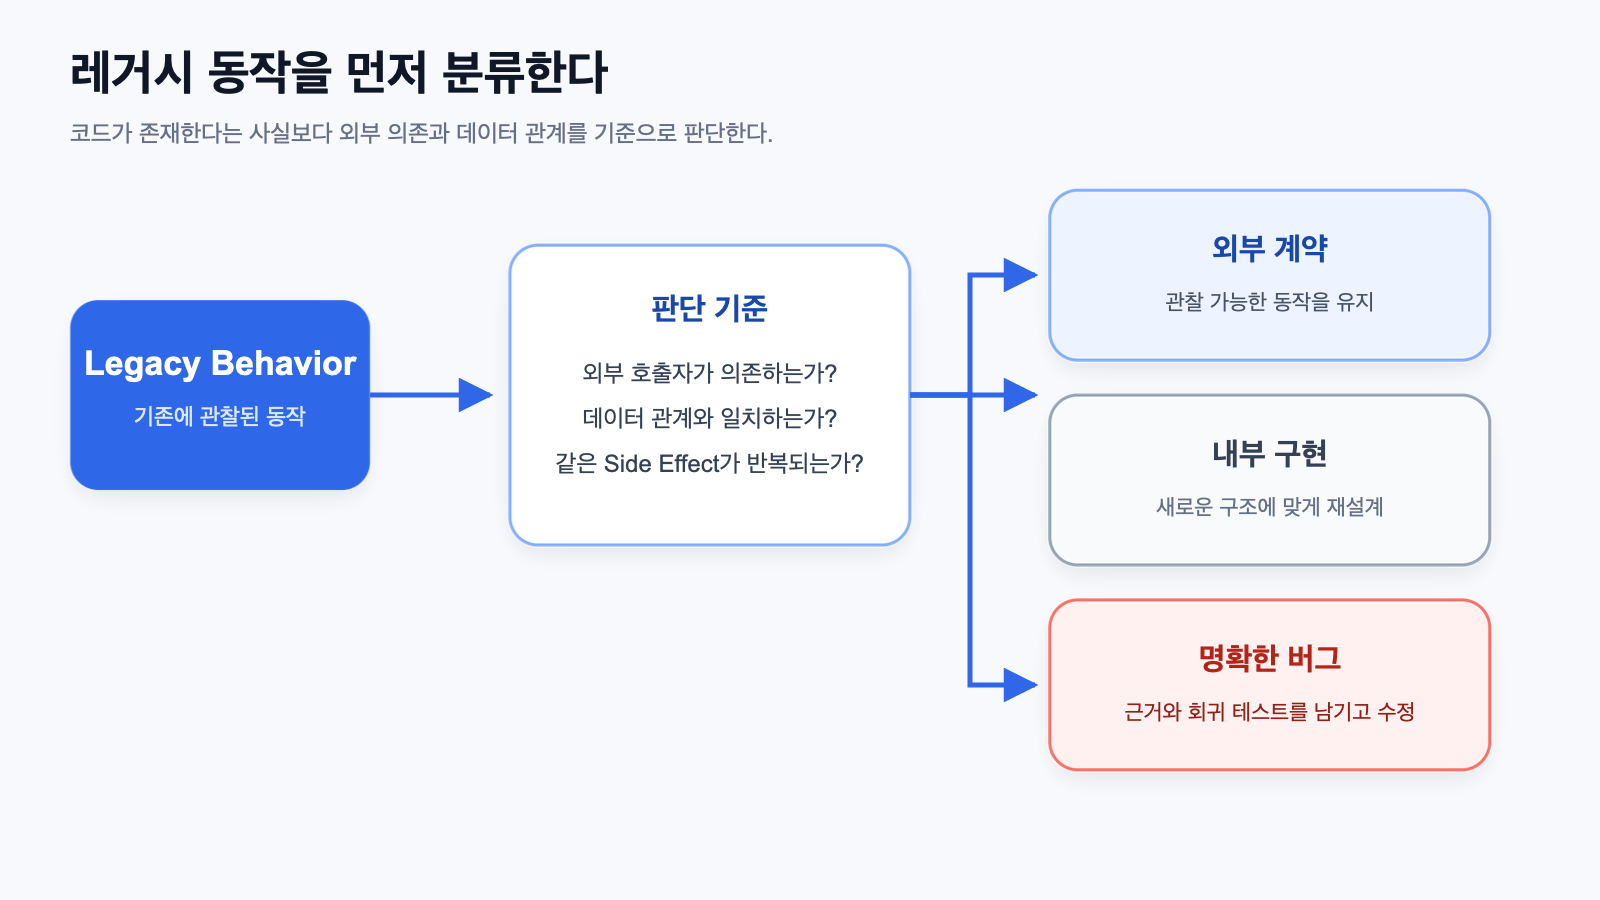
판단의 중심에는 한 가지 질문을 두었다.
이 동작을 바꾸면 시스템 외부에서 관찰할 수 있는 결과가 달라지는가?
외부 호출자가 의존하는 동작이라면 다소 불편해 보여도 우선 보존한다. 외부 계약과 무관한 구현은 새로운 구조에 맞게 바꾼다. 명세와 데이터 관계에 어긋나는 동작은 근거를 남기고 수정 후보로 분류한다. 버그라는 판단과 기존 호출자에게 변경을 적용해도 된다는 판단은 별개이므로, 결과가 달라지는 수정은 소비자 영향도 함께 확인한다.
기존 코드가 곧 명세는 아니다
레거시 코드에는 당시의 요구사항뿐 아니라 여러 시기의 수정과 우회가 누적돼 있다. 따라서 코드 한 줄이 존재한다는 사실만으로 그 동작을 유지해야 한다고 판단할 수는 없다.
이번 작업에서는 다음 순서로 근거를 확인했다.
- 현재 클라이언트와 외부 시스템이 실제로 사용하는 요청과 응답
- 운영 데이터가 표현하는 관계와 제약
- 기존 문서와 API 사용처
- 테스트가 보장하는 동작
- 마지막으로 레거시 구현 코드
예를 들어 외부 시스템이 특정 JSON 구조를 그대로 해석한다면 그 구조는 계약이다. 반면 API 서버가 어떤 테이블을 직접 조회하는지는 호출자가 관찰할 수 없는 구현 세부사항이다.
외부에서 관찰 가능
├── HTTP method와 path
├── request / response shape
├── status code와 오류
├── 외부 시스템으로 전달되는 payload
└── 요청 결과로 발생하는 side effect

내부에서만 관찰 가능
├── 조회하는 테이블
├── Repository 구성
├── 공통 검증 메서드
├── 트랜잭션 구현 방식
└── 내부 서비스 호출 경로
이 구분은 절대적이지 않다. 내부 구현처럼 보이는 timeout도 상대 시스템이 그 시간을 전제로 재시도한다면 계약이 될 수 있다. 결국 이름이나 코드 위치가 아니라 의존 관계를 조사해야 한다.
실제 사용 범위는 클라이언트에서 SQL까지 따라간다
이식 범위를 처음 나눌 때는 클라이언트가 직접 호출하지 않는 Controller라면 함께 연결된 기능도 제외할 수 있다고 생각했다. 실제 호출 목록과 Controller 이름만 대조하면 빠르게 범위를 줄일 수 있어 보였다.
하지만 이 기준은 한 번 틀렸다. 클라이언트가 사용하지 않는 Controller의 Module을, 사용 중인 다른 Controller가 공유하고 있었다. 겉으로 드러난 Endpoint는 미사용이어도 그 아래의 조회와 변환 로직은 여전히 실행되고 있었다. Controller 단위의 판단을 그대로 적용했다면 운영 중인 호출 경로에 필요한 테이블 이관을 빠뜨릴 수 있었다.
그 뒤부터는 사용 여부를 다음 경로로 추적했다.
배포된 클라이언트에 선언된 요청
        ↓
API 명세의 method · path
        ↓
Controller와 handler
        ↓
공유 Module · service
        ↓
실행되는 SQL과 참조 테이블
        ↓
클라이언트가 역직렬화하는 응답 모델
클라이언트에 선언된 요청 목록을 API 명세와 대조하고, 각 요청이 도달하는 Controller와 공유 Module을 따라가며 SQL과 테이블을 확인했다. 마지막에는 서버 응답만 보는 대신 클라이언트의 응답 모델까지 대조했다. 서버가 필드를 반환하더라도 클라이언트가 다른 이름이나 타입을 기대하면 계약을 보존한 것이 아니기 때문이다.
| 확인 대상 | 확인한 내용 | 이것만 봤을 때 놓칠 수 있는 것 |
|---|---|---|
| 클라이언트 요청 코드 | 앱이 사용하는 method와 path | 다른 클라이언트의 존재 |
| API 명세 | 라우팅되는 handler | 명세와 구현의 불일치 |
| Controller | 직접 호출하는 Module | 다른 Controller가 공유하는 Module |
| Module과 service | 실제 SQL과 변환 로직 | 동적 SQL과 간접 호출 |
| 응답 모델 | 필요한 필드명과 타입 | 쓰기 요청으로 되돌아가는 필드 |
| 접근 로그 | 코드 밖의 실제 호출 | 아직 한 번도 실행되지 않은 정상 기능 |
조사 과정에서 검색 방식 자체도 문제를 만들었다. 처음에는 소문자 SQL 키워드만 검색해 대문자로 작성된 FROM, INSERT INTO 일부를 놓쳤다. 또 SQL에 예전 컬럼명이 없다는 이유로 안전하다고 분류했지만, SELECT *로 가져온 행을 다음 줄에서 예전 속성명으로 읽는 코드가 있었다. 결국 테이블명이나 SQL 문자열 검색만으로는 충분하지 않았다. 조회 결과가 어떤 속성명으로 소비되는지까지 확인해야 했다.
이 경험 이후에는 미사용 Controller와 미사용 기능을 같은 뜻으로 보지 않는다. 먼저 클라이언트에서 SQL까지 이어지는 전체 도달 경로로 후보를 좁히고, 실제 제거 전에는 다른 클라이언트가 호출하는지 접근 로그로 확인해야 한다. 이번 조사에서도 코드만으로 확인하지 못한 호출자는 삭제 판단의 한계로 남겼다.
유지해야 할 외부 계약
새로운 서버에서도 기존 외부 시스템은 그대로 사용해야 했다. 외부 시스템의 코드를 동시에 바꿀 수 없었기 때문에 다음 항목은 이식 과정에서 유지했다.
- 외부 시스템을 호출하는 method와 path
- 외부로 전달하는 request body 구조
- 연결 확인과 요청에 사용하는 timeout
- 생성 경로에 따라 의미가 달라지는 초기 상태
- 기존 호출자가 사용하는 주요 응답 필드
특히 일부 수정 요청은 받은 본문을 외부 시스템으로 그대로 전달한다. 서버 입장에서 필드 이름이나 중첩 구조를 정리하고 싶더라도 외부 소비자가 기존 형태만 이해한다면 바꿀 수 없다.
async updateMode(resourceId: number, body: UpdateModeRequest) {
  await this.validateTarget(resourceId);

  // 외부 소비자가 기존 구조를 해석하므로 임의로 재구성하지 않는다.
  return this.externalClient.put(
    `/resources/${resourceId}/mode`,
    body,
  );
}
초기값도 단순히 숫자가 같고 다른 문제로 볼 수 없었다. 같은 종류의 자원이라도 생성 경로에 따라 초기 상태가 다른 이유가 있었고, 그 값을 하나로 통일하면 생성 직후의 상태 판정이 달라졌다. 이런 차이는 지저분한 중복이 아니라 의미가 있는 계약으로 분류했다.
호환성은 코드를 닮게 만드는 것이 아니라 관찰 가능한 결과를 유지하는 일이다.
우연히 살아남은 내부 구현은 다시 설계한다
외부 계약을 유지한다고 해서 내부 구조까지 그대로 옮길 필요는 없다. 실제 이식에서는 오래된 내부 경로를 다음과 같이 바꿨다.
흩어진 사전 검증을 하나로 모은다
레거시 API는 작업마다 연결 상태와 대상 존재 여부를 조금씩 다르게 확인했다. 같은 대상을 수정하는데도 어떤 API는 검증하고 다른 API는 건너뛰었다.
새로운 구현에서는 공통 준비 메서드가 검증 순서를 담당하도록 했다.
const target = await prepareUpdate(resourceId);

await transaction(async (manager) => {
  await updateResource(manager, target, command);
});

await notifyExternalSystem(target, command);
이렇게 하면 작업별 서비스는 변경 내용에 집중하고, 새로운 수정 API가 추가돼도 같은 검증 기준을 재사용할 수 있다.
데이터 저장과 외부 요청의 경계를 나눈다
여러 테이블을 갱신하는 작업은 하나의 DB Transaction으로 묶었다. 외부 HTTP 요청은 Transaction이 Commit된 뒤 실행했다.
사전 검증 → DB Transaction → Commit → 외부 시스템 전송네트워크 응답을 기다리는 동안 DB Lock을 유지하지 않기 위한 선택이다. 대신 Commit 이후 외부 전송이 실패하면 DB 변경은 남는다. 이 경우 전체 Rollback을 가장하는 대신 실패를 노출하고 재시도 가능한 작업으로 취급해야 한다.
다른 서비스의 저장 구조를 직접 알지 않는다
레거시 서버는 다른 데이터 저장소에 직접 접속해 물리 테이블을 선택했다. 새로운 서버에서는 해당 데이터를 소유한 서비스의 API를 호출하도록 바꿨다.
또한 같은 DB에 있는 정보를 얻기 위해 외부 서비스를 경유하던 조회는 내부 Repository 조회로 대체했다. 외부 결과는 유지하되 불필요한 네트워크 왕복과 저장 구조에 대한 결합은 제거했다.
명확한 기존 버그는 옮기지 않는다
기존과 결과가 다르다는 이유만으로 모든 변경을 회귀로 볼 수는 없다. 다음 조건을 만족하는 동작은 버그로 판단했다.
- 데이터 모델이 정의한 관계와 다른 ID를 사용한다.
- 같은 명령에서 동일한 외부 Side Effect가 반복된다.
- 조건상 제외해야 하는 대상에도 요청을 보낸다.
- 조회하지 않은 컬럼을 응답에 넣어 항상
undefined가 된다. - 명확한 필드명 오타가 외부 응답에 노출된다.
- 구현이 항상 고정값만 반환하고 실제 사용처도 없다.
버그를 수정할 때는 “새 코드가 더 깔끔하다”를 근거로 삼지 않았다. 스키마의 Foreign Key 의미, 실제 호출 조건, 조회한 컬럼, API 사용처처럼 확인 가능한 근거를 남겼다.
조건문 밖의 한 줄이 외부 요청을 중복시켰다
대표적인 버그는 동일한 외부 수정 요청이 한 번의 API 처리 중 여러 번 전송되는 문제였다.
레거시 코드를 단순화하면 다음과 비슷한 형태였다.
if (!isInternalOnly(resource)) {
  await sendUpdate(resource, payload);
}

// 다른 분기의 수정 과정에서 추가된 호출
await sendUpdate(resource, payload);
일반 대상에는 같은 요청이 두 번 이상 전달될 수 있었고, 외부 전송에서 제외해야 하는 대상에도 마지막 호출이 실행됐다.
DB의 동일한 SELECT를 두 번 실행하는 것과 외부 명령을 두 번 보내는 것은 다르다. 외부 요청은 설정 변경, 알림 발송, 파일 생성처럼 반복할 때 부작용이 발생할 수 있다. 상대 시스템이 멱등성을 보장한다는 근거도 없었다.
새 구현에서는 외부 호출 지점을 하나로 모으고 제외 조건을 호출 직전에 적용했다.
if (shouldNotifyExternalSystem(resource)) {
  await sendUpdate(resource, payload);
}
이 동작은 기존 코드와 다르다. 한 번의 수정 요청에서 외부 변경을 한 번만 보내도록 의도를 회복한 것이지만, 호출 횟수도 관찰 가능한 결과이므로 변경 사항에 남겨야 한다. 외부 시스템이 중복 요청에 의존하지 않는지와 제외 대상에 요청이 가지 않는지를 함께 확인하는 기준을 세웠다.
ID 이름이 아니라 관계가 가리키는 대상을 확인한다
또 다른 버그는 하위 이력을 조회할 때 잘못된 ID를 사용한 문제였다.
관련된 ID는 두 종류였다.
history.id          이력 행 자체의 ID
history.resource_id 원본 자원의 ID
child.parent_id     부모 자원의 ID
레거시 구현은 child.parent_id를 이력 행의 ID와 비교했다.
-- 잘못된 관계
WHERE child.parent_id = :historyRowId
하지만 parent_id가 가리키는 것은 이력 행이 아니라 원본 자원이었다.
-- 실제 데이터 관계
WHERE child.parent_id = :resourceId
이 문제는 SQL 오류를 발생시키지 않는다. 조건에 맞는 행이 없다는 빈 결과만 반환하기 때문에 정상 동작처럼 보이기 쉽다. 새로운 구현에서는 원본 자원 ID를 사용했고, 회귀 테스트에 조회 조건을 명시했다.
실제 테스트에서도 원본 ID와 이력 행 ID를 서로 다르게 뒀다. 예를 들어 원본 ID가 10, 이력 행 ID가 900이면 자식 조회에는 10이 전달돼야 한다. 두 ID를 같은 값으로 만들면 잘못된 조회 조건도 테스트를 통과할 수 있기 때문이다.
expect(historyRepository.find).toHaveBeenCalledWith(
  expect.objectContaining({
    where: {
      scopeId,
      parentId: resourceId,
    },
  }),
);
레거시 이식에서 ID 이름이 비슷하다는 이유로 코드를 그대로 옮기면 안 된다. 컬럼이 표현하는 관계와 실제 값의 생명주기를 확인해야 한다.
응답 중복이 사라졌다고 바로 호환된다고 판단하지 않았다
호환 서버에서는 권한 조회를 옮기며 다른 종류의 차이를 발견했다. 기존 SQL은 권한 번호만으로 조인했지만, 실제 데이터에서는 같은 권한 번호가 여러 업무 유형에 존재할 수 있었다.
업무 유형 A + 권한 번호 3
업무 유형 B + 권한 번호 3
권한 번호 3만 조건으로 걸면 한 사용자에 두 행이 연결될 수 있다. 새 구현의 권한 매핑에서는 이 중복이 사라졌다. 겉보기에는 조회 코드를 바꿨을 뿐이지만 응답의 행 수까지 달라지는 변경이었다.
여기서 “새 응답이 더 깔끔하다”는 이유로 같은 결과라고 기록하지 않았다. 기존 조인에서 빠진 조건과 새 매핑의 기준을 근거로, 잠재적인 중복 응답을 바로잡는 변경으로 구분했다.
이런 사례에서는 다음 세 가지를 각각 비교해야 한다.
- 행 수가 줄어든 이유가 중복 제거인지, 필요한 권한의 누락인지
- 같은 권한 번호를 가진 다른 업무 유형이 섞이지 않는지
- 클라이언트가 첫 행만 읽거나 배열 전체를 사용하는지
응답 필드의 이름과 타입이 같아도 계약이 보존됐다고 단정할 수 없다. 조인 조건이 바뀌면 데이터의 개수와 의미도 달라질 수 있다.
삭제 동작을 이식할 때는 소유 범위부터 정의한다
조회와 수정은 대상 행이 잘못되면 비교적 빠르게 드러난다. 삭제는 더 위험하다. 조건이 너무 좁으면 고아 데이터가 남고, 너무 넓으면 다른 기능이 소유한 데이터까지 사라진다.
부모와 자식으로 구성된 자원을 예로 들면 부모 행 하나만 삭제해서는 충분하지 않았다.
부모 자원
├── 자식 자원 A
├── 자식 자원 B
└── 부모와 자식이 만든 파생 데이터
부모만 삭제하면 화면에서는 사라진 것처럼 보여도 자식이나 파생 데이터가 계속 활성 상태로 남을 수 있다. 반대로 부모와 자식의 ID만 조건으로 파생 데이터를 모두 삭제하면, 우연히 같은 ID를 참조하던 다른 종류의 데이터까지 영향을 받을 수 있다.
따라서 삭제 대상을 찾을 때는 참조 ID 외에 그 데이터가 어느 기능에서 만들어졌는지를 함께 확인해야 한다.
const targetIds = [parentId, ...childIds];

await markDeleted({
  scopeId,
  ownerId: In(targetIds),
  dataId: Between(featureOwnedRange.start, featureOwnedRange.end),
});

await clearOwnerReference({
  scopeId,
  ownerId: In(targetIds),
  dataId: Not(Between(featureOwnedRange.start, featureOwnedRange.end)),
});
이 예시에서 첫 번째 집합은 해당 기능이 직접 만든 데이터이므로 함께 비활성화한다. 두 번째 집합은 다른 기능이 만들었지만 현재 자원을 참조하고 있을 뿐이므로 데이터를 삭제하지 않고 참조만 해제한다.
삭제하면서 사용 상태도 함께 내려야 한다. deleted = 1인데 used = 1인 행을 남기면 조회 화면에서는 보이지 않지만 실행 조건에는 계속 포함될 수 있다. 부모를 지울 때는 살아 있는 자식을 먼저 확정하고, 부모와 자식의 삭제 상태·사용 상태·파생 데이터·외부 전송 순서를 하나의 삭제 계약으로 다뤄야 한다.
이 과정에서 중요한 질문은 “레거시 코드가 무엇을 지웠는가”가 아니라 다음 두 가지다.
- 이 자원을 삭제했을 때 함께 없어져야 하는 것은 무엇인가?
- 같은 ID를 참조하더라도 반드시 보존해야 하는 것은 무엇인가?
삭제 범위를 좁히는 수정과 넓히는 수정은 반대처럼 보이지만, 실제로는 모두 소유권을 정확히 정의하는 같은 작업이다.
레거시 테이블의 이름에 소유와 수명을 남긴다
사용 경로를 SQL까지 추적하면서 새 시스템의 정본 스키마에 없는 테이블도 발견했다. 처음에는 오래된 화면에서만 쓰는 데이터라 이식 대상에서 제외할 수 있다고 생각했지만, 실제 클라이언트가 호출하는 API가 그 테이블을 직접 조회하고 있었다. API 코드를 옮기는 것만으로는 기능이 동작하지 않으므로 필요한 테이블도 새 환경에서 접근할 수 있게 해야 했다.
문제는 테이블을 어디에 둘지였다.
| 선택지 | 장점 | 부담과 위험 |
|---|---|---|
| 기존 이름으로 공용 스키마에 추가 | 새 연결 설정 없이 기존 Query를 옮기기 쉬움 | 새 시스템의 영구 테이블처럼 보이고 일반적인 이름이 충돌할 수 있음 |
| 레거시 전용 스키마로 분리 | 소유권과 삭제 범위가 분명함 | Connection Pool, 권한, 백업과 배포 절차가 하나 더 필요함 |
| 공용 스키마에 소유 접두사를 붙여 추가 | 기존 운영 구성을 유지하면서 출처와 수명을 표시 | Query 변환이 필요하고 일부 이름이 길어짐 |
처음에는 사용하는 클라이언트를 나타내는 접두사를 검토했다. 그런데 같은 공용 스키마에 이미 그 접두사를 쓰는 다른 테이블이 있었고, 새로 옮길 테이블과 소유 주체도 폐기 시점도 달랐다. 이름만 맞춰 넣으면 나중에는 어느 테이블이 이번 이식에서 들어온 것인지 다시 조사해야 한다.
그래서 기능 이름이 아니라 레거시 시스템이 소유한 데이터라는 사실을 나타내는 접두사를 선택했다.
이식 전
lookup_code
display_setting
resource_setting

이식 후
legacy_lookup_code
legacy_display_setting
legacy_resource_setting
이름을 바꾸면서 레거시 Query를 그대로 복사할 수는 없게 됐지만 다음 경계가 생겼다.
- 공용 스키마에 있어도 새 시스템의 핵심 테이블과 구분된다.
- 어떤 호환 서비스가 이 테이블을 사용하는지 찾기 쉽다.
- 레거시 서비스가 폐기될 때 정리 후보를 접두사로 모을 수 있다.
- 새 시스템이 같은 의미의 데이터를 다시 설계하더라도 이름이 충돌하지 않는다.
모든 테이블 이름을 완벽하게 통일하지는 못했다. 같은 이식 범위에 속하지만 이전 작업에서 이미 접두사 없이 추가된 테이블도 있었다. 이를 다시 이름 바꾸면 운영 데이터와 기존 Query를 함께 마이그레이션해야 하므로, 이번에는 예외로 유지하고 소유 주체와 사용처를 문서에 명시했다.
일관된 이름이 중요하더라도 이미 운영 중인 구조를 정리하기 위해 새로운 위험을 만드는 것은 목적과 맞지 않았다. 중요한 것은 예외가 없다는 사실이 아니라 왜 예외가 생겼고 언제 제거하거나 다시 설계할지 설명할 수 있는 상태였다.
테이블을 추가하기 전에는 관리 대상 저장소 전체에서 원래 이름과 후보 이름을 검색했다. 흔한 단어는 변수명이나 상태 문자열에서도 많이 발견됐기 때문에 단순 검색 건수를 사용하지 않고, 실제 SQL의 FROM, JOIN, INSERT, UPDATE와 조회 결과 사용처인지 확인했다. 이 과정을 거쳐야 이름 충돌뿐 아니라 예상하지 못한 다른 소비자도 찾을 수 있었다.
레거시 테이블 배치를 결정할 때는 다음 질문을 함께 확인했다.
- 이 테이블의 기준 데이터를 관리하는 시스템은 어디인가?
- 새 시스템의 영구 모델인가, 전환 기간에만 필요한 호환 데이터인가?
- 호환 서비스가 종료되면 함께 제거할 수 있는가?
- 같은 접두사를 쓰는 기존 테이블의 소유 주체와 수명이 같은가?
- 별도 스키마로 분리할 때 추가되는 연결·권한·백업 비용을 감수할 이유가 있는가?
- 접두사 없이 남은 예외와 그 이유가 기록돼 있는가?
레거시 테이블의 이름은 단순한 표기 취향이 아니었다. 현재 누가 소유하며 어떤 시스템이 사라질 때 함께 정리할 수 있는지 나타내는 운영 경계였다.
하나의 범용 API를 역할별 API로 나눈다
기존에는 하나의 수정 Endpoint가 요청 본문에 따라 여러 역할을 처리했다.
PUT /resources/{id}
├── 사용 상태 변경
├── 설정 변경
├── 연결 관계 변경
├── 시간 범위 변경
└── 부가 정보 변경
외부에서 보면 Endpoint 수가 적어 단순해 보이지만 서버 내부에서는 어떤 필드가 들어왔는지에 따라 검증, Transaction, 이력, 외부 요청이 모두 달라졌다. 새로운 시스템에서는 역할별 API와 서비스 메서드로 분리했다.
updateUsed(command);
updateConfiguration(command);
updateBindings(command);
updateTimeRange(command);
updateMetadata(command);
분리한 뒤에는 각 작업의 경계가 분명해졌다.
- 작업별 DTO에서 허용 필드를 제한할 수 있다.
- 필요한 테이블만 Transaction에 포함한다.
- 외부 시스템으로 보낼 payload가 명확해진다.
- 역할별로 성공과 실패 테스트를 작성할 수 있다.
- 한 기능의 변경이 다른 수정 경로에 미치는 영향을 줄인다.
Endpoint 구조는 달라졌지만 이것은 무조건적인 호환성 파괴가 아니다. 새로운 API의 호출자가 함께 전환되는 범위에서는 오래된 범용 구조를 유지하는 것보다 역할을 명시하는 편이 안전했다. 반대로 기존 클라이언트가 새 서버를 그대로 호출해야 했다면 Adapter나 Gateway에서 기존 계약을 변환하는 계층이 필요했을 것이다.
옮기지 않는 것도 이식 결과다
레거시 기능 중에는 새로운 스키마에 대상 테이블이 없는 정리 작업이 있었다. 이를 조용히 생략하면 나중에 누락인지 의도적인 보류인지 알 수 없다.
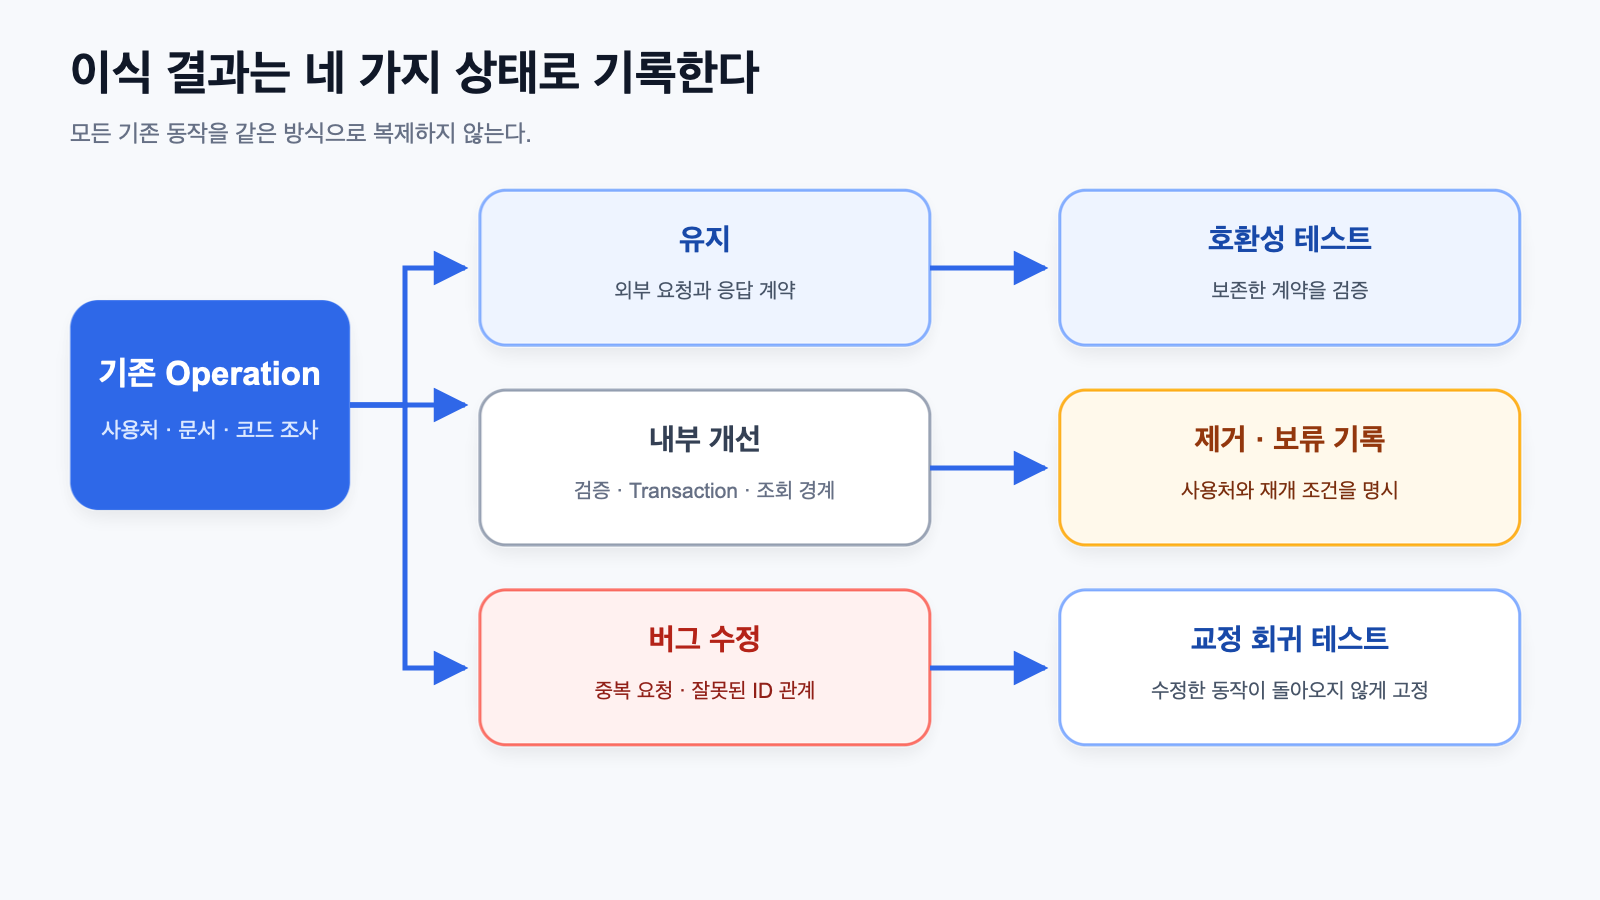
그래서 이식 현황표에 다음 상태를 구분해 기록했다.
| 분류 | 의미 | 필요한 증거 |
|---|---|---|
| 유지 | 외부 계약을 같은 형태로 제공 | 호환성 테스트 |
| 내부 개선 | 외부 결과는 같고 구현만 변경 | 기능·통합 테스트 |
| 버그 수정 | 잘못된 기존 동작을 의도적으로 변경 | 원인과 회귀 테스트 |
| 제거 | 사용처가 없고 의미도 없는 기능 | 사용처 조사 결과 |
| 보류 | 현재 구조에서는 구현할 수 없거나 범위 밖 | 제약과 재개 조건 |
항상 true만 반환하던 더미 API는 사용처를 확인한 뒤 이식하지 않았다. 새로운 스키마에 없는 데이터를 정리하는 기능은 제거로 단정하지 않고 보류로 기록했다. 필요한 테이블과 생성·삭제 흐름이 함께 마련될 때 다시 검토할 수 있도록 조건도 남겼다.
이식률을 높이기 위해 빈 Endpoint를 만들어 두는 것보다, 하지 않은 일과 이유를 드러내는 편이 안전하다.
이식 현황표와 회귀 테스트를 함께 관리한다
이식 현황표에는 단순히 완료 여부만 적지 않았다. 기존 Operation과 새로운 Endpoint의 대응, 의도적으로 달라진 점, 남은 제약, 옮기지 않은 기능을 함께 기록했다.
기존 Operation
      ↓
새 Endpoint / Service method
      ↓
유지 · 내부 개선 · 버그 수정 · 제거 · 보류
      ↓
판단 근거와 검증 Test
테스트도 목적에 따라 구분했다.
호환성 테스트
유지하기로 한 요청 본문, 외부 호출 경로, 응답 형태가 바뀌지 않았는지 확인한다.
교정 테스트
잘못된 ID 관계처럼 수정한 버그가 다시 들어오지 않는지 확인한다. 기존 결과와 같음을 확인하는 테스트가 아니라, 의도적으로 달라진 결과를 고정하는 테스트다.
역할별 테스트
생성, 수정, 삭제, 상세 조회, 이력, 상태 변경처럼 분리된 기능이 자신의 책임만 수행하는지 확인한다. 여러 행을 바꾸는 작업은 Transaction 호출과 실패 시 동작도 검증한다.
외부 Side Effect 테스트
외부 요청의 경로와 payload뿐 아니라 호출 조건과 횟수를 검증해야 한다.
expect(externalClient.put).toHaveBeenCalledTimes(1);
expect(externalClient.put).toHaveBeenCalledWith(
  expectedPath,
  expectedPayload,
);
삭제 범위 테스트
삭제 테스트는 대상이 사라졌는지만 확인해서는 부족하다.
- 부모를 삭제하면 살아 있는 자식도 함께 비활성화된다.
- 삭제된 행의 사용 상태도 함께 내려간다.
- 해당 기능이 만든 파생 데이터만 삭제된다.
- 다른 기능이 만든 데이터는 보존하고 끊어진 참조만 해제한다.
- 외부 시스템에는 자식과 부모를 합의된 순서와 횟수로 전달한다.
회귀 테스트는 잘못된 부모 ID 조회뿐 아니라 부모·자식 삭제, 사용 상태 변경, 파생 데이터의 삭제 범위도 검증한다. 중복 외부 요청처럼 호출 횟수가 핵심인 버그는 전용 Assertion을 추가해 의도를 더 명확히 고정할 필요가 있다.
판단할 때 주의할 점
오타도 이미 소비되고 있다면 호환성 문제다
새 조회 API에서는 호출자도 함께 전환하는 범위에 한해 응답 필드명의 오타를 바로잡았다. 예를 들어 dispaly_name을 display_name으로 고치는 경우, 기존 앱이 오타가 있는 이름을 읽고 있다면 같은 수정을 그대로 적용할 수 없다.
호환 경로에서는 기존 이름을 유지하거나 변환 계층에서 매핑하고, 호출자가 바뀌는 시점에 새 이름으로 전환해야 한다. 오타라는 근거는 수정 이유를 설명하지만 무중단 전환까지 보장하지 않는다.
이상해 보인다고 바로 고치지 않는다
오래된 필드명이나 비대칭적인 응답도 외부 사용처가 의존하면 계약일 수 있다. 정리하고 싶다면 기존 Endpoint를 그대로 바꾸기보다 Versioning이나 변환 계층을 검토해야 한다.
테스트가 있다고 무조건 계약은 아니다
테스트도 잘못된 구현을 그대로 고정했을 수 있다. 테스트가 무엇을 보장하는지와 그 기대값의 근거를 함께 확인해야 한다.
문서만으로 사용 여부를 단정하지 않는다
문서에 없는 API를 실제 클라이언트가 호출할 수 있고, 문서에 있는 API가 더미로 남아 있을 수도 있다. 호출 코드와 운영 로그를 함께 확인하는 것이 안전하다.
Mock이 통과해도 실제 응답과 호환된다는 뜻은 아니다
기존 Helper나 외부 호출을 Stub으로 대체한 테스트는 내부 분기 검증에는 유용하지만, 실제 HTTP 응답의 누락 필드와 null, 날짜 직렬화, 필드 교체 규칙까지 보장하지는 않는다.
이식 전후의 실제 응답을 Fixture로 남기고 새 구현에 넣어 보는 Contract Test가 필요하다. 가능하다면 실제 소비자가 그 응답을 읽고 다시 쓰는 경로까지 확인해야 한다. 읽기 응답이 같아 보여도 소비자가 전체 객체를 수정해 되쓰는 구조라면, 서버가 생략한 필드 하나가 다음 쓰기에서 데이터 삭제로 이어질 수 있다.
내부 개선에도 실패 경계가 달라질 수 있다
외부 HTTP 호출을 Commit 뒤로 옮기면 DB와 외부 시스템 사이에 일시적인 불일치가 생길 수 있다. Transaction을 깔끔하게 만들었다는 이유만으로 끝내지 말고 실패를 어떻게 관찰하고 재시도할지 정의해야 한다.
응답 비교에서 바로 사용할 점검표
기존 서버의 응답을 새 서버의 정답으로 그대로 복사하면 이미 발견한 버그까지 고정된다. 그래서 유지할 값과 의도적으로 달라질 값을 먼저 나눠 비교하는 편이 좋다.
| 사례 | 유지할 결과 | 의도적으로 바뀌는 결과·확인할 조건 |
|---|---|---|
| 기존 앱의 상세 조회 | 앱이 읽는 필드명·타입·빈 값 표현 | 내부 테이블명이 달라도 응답은 유지 |
| 자원 이력의 자식 조회 | 자원과 자식의 실제 관계 | 이력 PK 대신 원본 ID로 조회 |
| 외부 수정 요청 | 합의된 경로와 본문 | 일반 대상은 한 번, 제외 대상은 호출 없음 |
| 권한 조회 | 해당 업무 유형에서 유효한 권한 | 잘못된 조인에 의한 중복만 제거 |
| 부모 자원 삭제 | 부모·자식의 비활성화 | 다른 기능이 만든 데이터는 보존 |
| 신규 API의 오타 정정 | 필드가 담는 의미 | 새 이름을 소비하는 호출자와 함께 전환 |
회귀용 데이터에는 정상 사례만 넣지 않는다. 이력 ID와 원본 ID가 다른 행, 서로 다른 업무 유형의 같은 권한 번호, 다른 기능의 데이터를 참조하는 자원을 넣어야 판단을 틀리게 했던 조건을 다시 확인할 수 있다.
실제 응답을 비교할 때도 배열을 무조건 정렬하거나 null과 누락 필드를 같은 값으로 바꾸지는 않는다. 순서나 빈 값 구분을 앱이 사용한다면 그 차이도 계약이기 때문이다. 반대로 매번 달라지는 서버 처리 시각처럼 비교에서 제외할 값은 이유를 기록한다.
이력 조회와 삭제 범위는 회귀 테스트로 검증하지만, 이것만으로 기존 앱과의 전체 호환성을 보장할 수는 없다. 전체 응답을 비교하는 계약 테스트와 접근 로그 점검까지 함께 수행해야 실제 사용 경로의 누락을 찾을 수 있다.
마치며
레거시 API 이식은 기존 코드를 다른 Framework 문법으로 번역하는 작업이 아니었다. 오래된 동작을 하나씩 조사하고 어떤 것은 보존하며, 어떤 것은 다시 설계하고, 어떤 것은 수정하거나 옮기지 않기로 결정하는 과정이었다.
이번 작업에서 사용한 기준은 다음과 같다.
- 외부 호출자가 의존하는 요청·응답과 Side Effect는 계약으로 보존한다.
- 테이블 접근이나 서비스 호출 경로 같은 내부 구현은 새로운 경계에 맞게 재구성한다.
- 중복 외부 요청과 잘못된 ID 관계는 근거를 남기고 수정한다.
- 삭제는 부모·자식과 파생 데이터의 소유 범위를 함께 정의한다.
- 레거시 테이블의 이름에는 현재 소유 주체와 예상 수명을 드러낸다.
- 하나의 범용 API는 역할별 API로 분리해 검증과 변경 범위를 명확히 한다.
- 제거와 보류를 누락과 구분해 이식 현황표에 기록한다.
- 호환성 테스트와 버그 교정 테스트의 목적을 나눈다.
- 외부 요청은 결과뿐 아니라 호출 조건과 횟수까지 검증한다.
- Mock뿐 아니라 실제 직렬화된 응답을 사용한 Contract Test로 소비자 호환성을 확인한다.
레거시와 다르다는 사실만으로 새 구현이 잘못된 것은 아니다. 무엇을 유지하고 무엇을 바꿀지 설명할 수 있고, 그 판단을 문서와 테스트로 다시 확인할 수 있어야 안전한 이식이라고 할 수 있다.
이식 대상을 검토할 때는 다음 목록을 마지막으로 확인한다.
- 배포된 클라이언트에 선언된 method와 path를 기준으로 사용 경로를 찾았는가?
- 사용 중인 Controller가 공유하는 Module과 service까지 추적했는가?
- SQL의 대소문자,
SELECT *, 동적 쿼리 때문에 검색에서 빠진 참조가 없는가? - 클라이언트가 기대하는 응답 필드명과 타입을 확인했는가?
- 기존 호출자를 유지하는 경로와 호출자도 함께 바꾸는 경로를 구분했는가?
- 빈 값·배열 순서·행 수의 차이를 임의로 정규화해 숨기지 않았는가?
- 서로 다른 ID나 같은 번호의 다른 업무 유형을 테스트 데이터에 넣었는가?
- 유지·내부 개선·버그 수정·제거·보류의 근거를 각각 기록했는가?
- 외부 요청의 payload뿐 아니라 호출 조건과 횟수를 검증했는가?
- 삭제되는 데이터와 참조만 해제되는 데이터의 소유 범위를 구분했는가?
- 이식한 테이블의 소유 주체와 폐기 조건이 이름이나 문서에 드러나는가?
- 접두사 후보가 기존 테이블의 이름·소유권과 충돌하지 않는가?
- 접두사 없이 남긴 예외와 그 이유를 기록했는가?
- 제거 후보가 다른 클라이언트에서 호출되는지 접근 로그로 확인했는가?
'Backend > Architecture' 카테고리의 다른 글
| [Architecture] 엣지 서버의 로컬 ID와 전역 ID 충돌을 피하는 방법 (0) | 2026.09.20 |
|---|---|
| [Server] 사용자 JWT와 장비 Token의 인증 경계를 분리하기 (0) | 2026.09.19 |
| [Server] 대용량 ZIP을 생성하면서 API Gateway 너머로 스트리밍하기 (0) | 2026.09.12 |
| [Design Pattern] 서로 다른 데이터 스키마를 하나의 API로 다루기 (0) | 2026.08.18 |
| [Server] 보상 작업으로 다단계 생성 흐름의 실패 범위 줄이기 (0) | 2026.08.15 |
| [Server] 여러 API 서비스의 인증을 Gateway에 모은 이유 (0) | 2026.08.08 |


